Mindset
La piramide delle evidenze è troppo semplice: come capire davvero se uno studio è affidabile
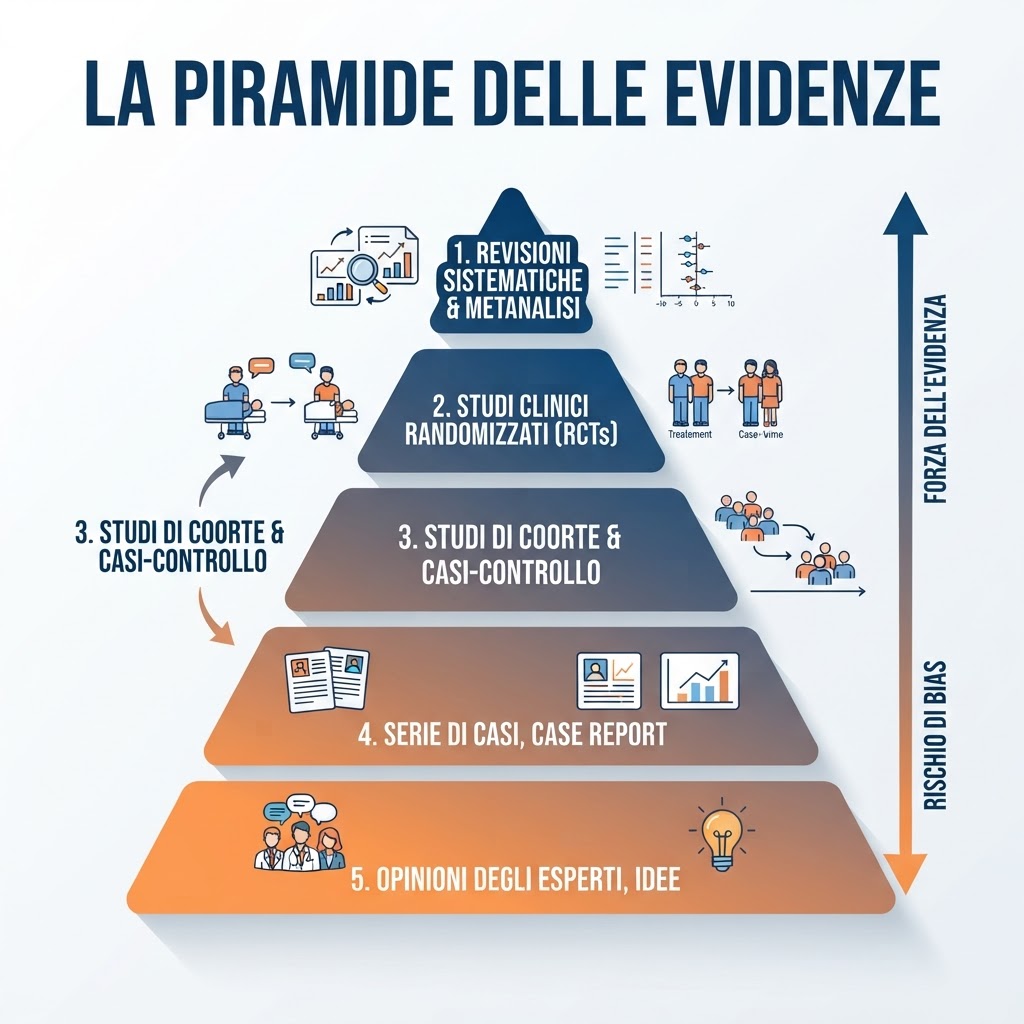
RCT in alto, case report in basso: utile per iniziare, ma la scienza non funziona come una classifica rigida. Una meta-analisi può essere pessima, uno studio osservazionale può essere decisivo e la qualità dipende dalla domanda. Ecco come leggere davvero le evidenze senza farsi ingannare.
Riedizione aggiornata di “La Piramide delle Evidenze: perché non tutte le ricerche sono uguali”, Biohacking Now, Primavera 2025.
“Lo dice uno studio” è una delle frasi più pericolose del biohacking.
Non perché gli studi non servano. Ma perché un singolo studio può essere piccolo, mal disegnato, sponsorizzato, non replicato o semplicemente rispondere a una domanda diversa da quella che gli stiamo facendo.
La vecchia piramide delle evidenze ci ha insegnato una cosa utile: non tutte le prove hanno lo stesso peso. Ma oggi sappiamo che trasformarla in una classifica rigida è troppo semplice.
Perché la piramide è utile
Un case report descrive un caso. Un RCT randomizza partecipanti. Una systematic review cerca di sintetizzare l’intera letteratura. È ragionevole attribuire, in generale, maggiore capacità causale a disegni che controllano meglio bias e confondenti.
Per questo gli RCT restano centrali quando vogliamo sapere se un intervento causa un effetto.
Ma una meta-analisi non vince automaticamente
Una meta-analisi può combinare studi piccoli, eterogenei o con alto rischio di bias. Se il materiale di partenza è debole, la statistica non lo trasforma in oro.
Il principio “garbage in, garbage out” resta valido.
Per questo oggi strumenti come GRADE valutano la certezza del corpo complessivo di evidenza, non solo il tipo di studio.
Cosa guarda GRADE
- rischio di bias;
- inconsistenza tra studi;
- indirectness: quanto la popolazione e l’intervento studiati corrispondono alla domanda reale;
- imprecisione delle stime;
- publication bias.
Il risultato finale non è “RCT = vero”, ma una valutazione della certezza: alta, moderata, bassa o molto bassa.
La domanda viene prima del disegno
Se voglio sapere se un farmaco riduce la pressione, un RCT è ideale.
Se voglio sapere se fumare aumenta il rischio di tumore dopo decenni, non posso randomizzare persone al fumo per 30 anni. Gli studi osservazionali diventano fondamentali.
Se devo identificare un effetto avverso rarissimo, un trial di 300 persone può essere quasi inutile rispetto a grandi database di farmacovigilanza.
La “migliore evidenza” dipende quindi dalla domanda.
Nel biohacking il problema è ancora più grande
Molti interventi partono da:
- studi cellulari;
- modelli animali;
- piccoli trial pilota;
- biomarcatori surrogate;
- esperienze personali.
Queste fonti possono essere preziose per generare ipotesi. Il problema nasce quando vengono raccontate come prova clinica.
Meccanismo non significa beneficio
Un intervento può aumentare ATP, attivare AMPK o ridurre un marker infiammatorio. Non segue automaticamente che riduca mortalità, demenza o infarto.
Nel biohacking questa è forse la distinzione più importante: plausibilità biologica e beneficio clinico sono due livelli diversi.
Animali non sono esseri umani in miniatura
Uno studio su topi può essere elegantissimo e molto utile. Ma dose, metabolismo, durata della vita e modello di malattia possono rendere difficile la traduzione.
Quando leggiamo “allunga la vita del 20%”, la prima domanda dovrebbe essere: in quale specie?
Biomarker non sono outcome
Abbassare CRP, migliorare HRV o modificare un epigenetic clock può essere interessante. Ma questi segnali possono essere intermedi.
Un surrogate endpoint diventa davvero potente quando è validato come predittore affidabile dell’outcome clinico che ci interessa.
Come leggere uno studio in 60 secondi
- Popolazione: chi è stato studiato?
- Numero: quanti partecipanti?
- Confronto: esisteva un controllo adeguato?
- Durata: abbastanza lunga per l’effetto dichiarato?
- Endpoint: clinico o biomarcatore?
- Entità: l’effetto è grande o solo statisticamente significativo?
- Replicazione: altri gruppi hanno ottenuto risultati simili?
- Conflitti: chi ha finanziato lo studio?
Statistical significance non significa importanza
Con campioni enormi, differenze minuscole possono diventare statisticamente significative. La domanda clinica è: quanto cambia davvero?
Guardare intervalli di confidenza ed effetto assoluto è spesso più informativo del solo p-value.
Il nuovo modello mentale
Non pensare alla letteratura come una piramide immobile.
Pensala come una rete di prove con qualità diverse che convergono — oppure no — sulla stessa conclusione.
Conclusione
Il biohacker scientificamente maturo non cerca lo studio che conferma ciò che vuole fare.
Cerca la totalità delle prove, soprattutto quelle che potrebbero smentirlo.
La domanda non è “esiste uno studio?”. È “quanto è forte l’intero corpo di evidenze che sostiene questa affermazione?”
Riferimenti essenziali
- Cochrane Handbook for Systematic Reviews of Interventions. Chapter 24: Including non-randomized studies on intervention effects.
- GRADE Working Group. Framework for rating certainty of evidence: risk of bias, inconsistency, indirectness, imprecision and publication bias.
Autore
Claudio Di Vincenzo
Mi occupo di gestione delle risorse umane da circa 30 anni in aziende di medio-grandi dimensioni